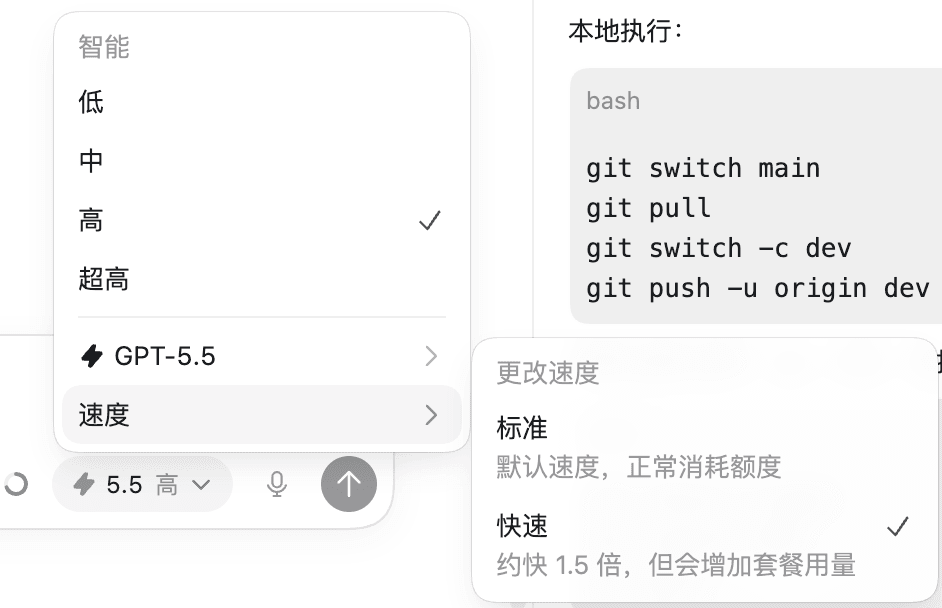
GPT-5.5 来了!价格翻倍但能力翻了不止一倍,OpenAI 逆风翻盘
OpenAI 推出了 GPT-5.5。先说结论,我觉得开发上Claude的位置要动摇了。GPT-5.5 能理解复杂目标、使用工具、检查自己的工作,并把更多任务执行到完成。
OpenAI 推出了 GPT-5.5。先说结论,我觉得开发上Claude的位置要动摇了。GPT-5.5 能理解复杂目标、使用工具、检查自己的工作,并把更多任务执行到完成。
从对话到执行
之前的 GPT 模型主要是回答问题,给建议。GPT-5.5 的核心改进是它能真正完成任务。
OpenAI 在官方博客中举了个例子:他们的传播团队用 GPT-5.5 分析了六个月的演讲邀请数据,建立了一套评分和风险评估框架,还验证了一个自动化的 Slack 机器人。
低风险的请求可以自动处理,高风险的请求仍然会转给人工审核。这不是简单的数据分析,而是从理解需求到设计方案再到验证实施的完整流程。
在 Codex(OpenAI 的智能编程平台)中,GPT-5.5 的表现更明显。有测试者给它一个写得很乱的代码库,让它"整理成一个好的代码库",GPT-5.5 能理解这个模糊的要求,自己判断什么是"好",然后重构代码。
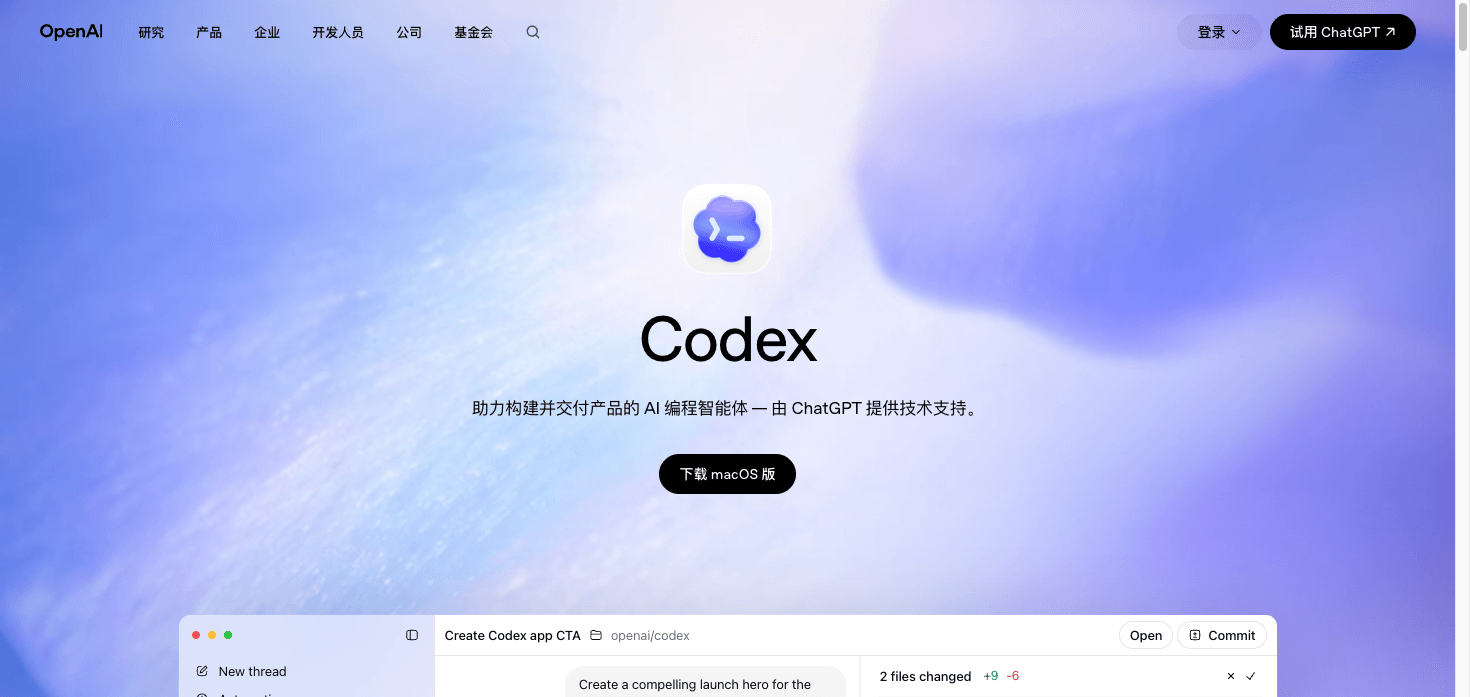 OpenAI Codex 界面
性能提升在哪里
从基准测试来看,GPT-5.5 在 10 个可对比的基准测试中有 9 个都超过了 GPT-5.4,最大的提升出现在 ARC-AGI-2(抽象推理)、MCP Atlas(多工具协作)和 Terminal-Bench 2.0(终端操作)这三个测试上。
这些测试项目不需要推理、规划和工具使用的复杂任务。GPT-5.5 在这些方面的提升,说明它确实更适合处理真实工作场景。
价格方面,GPT-5.5 的每 token 价格翻倍了,但延迟没有增加。
OpenAI 声称在同等智能水平下,GPT-5.5 的成本是竞争对手前沿编程模型的一半。
用户怎么说
有人觉得 GPT-5.5 "强得可怕",特别是在 Cursor 的 Agent 模式中使用时,完成任务的能力明显提升。也有人觉得发布会出错又无聊,但实际测试后改观了。
一个比较一致的反馈是:GPT-5.5 减少了过度附和的行为。在专门设计的谄媚测试中,谄媚回复率从 14.5% 降到了不足 6%。它用的表情符号更少,回应更细腻和深思熟虑。