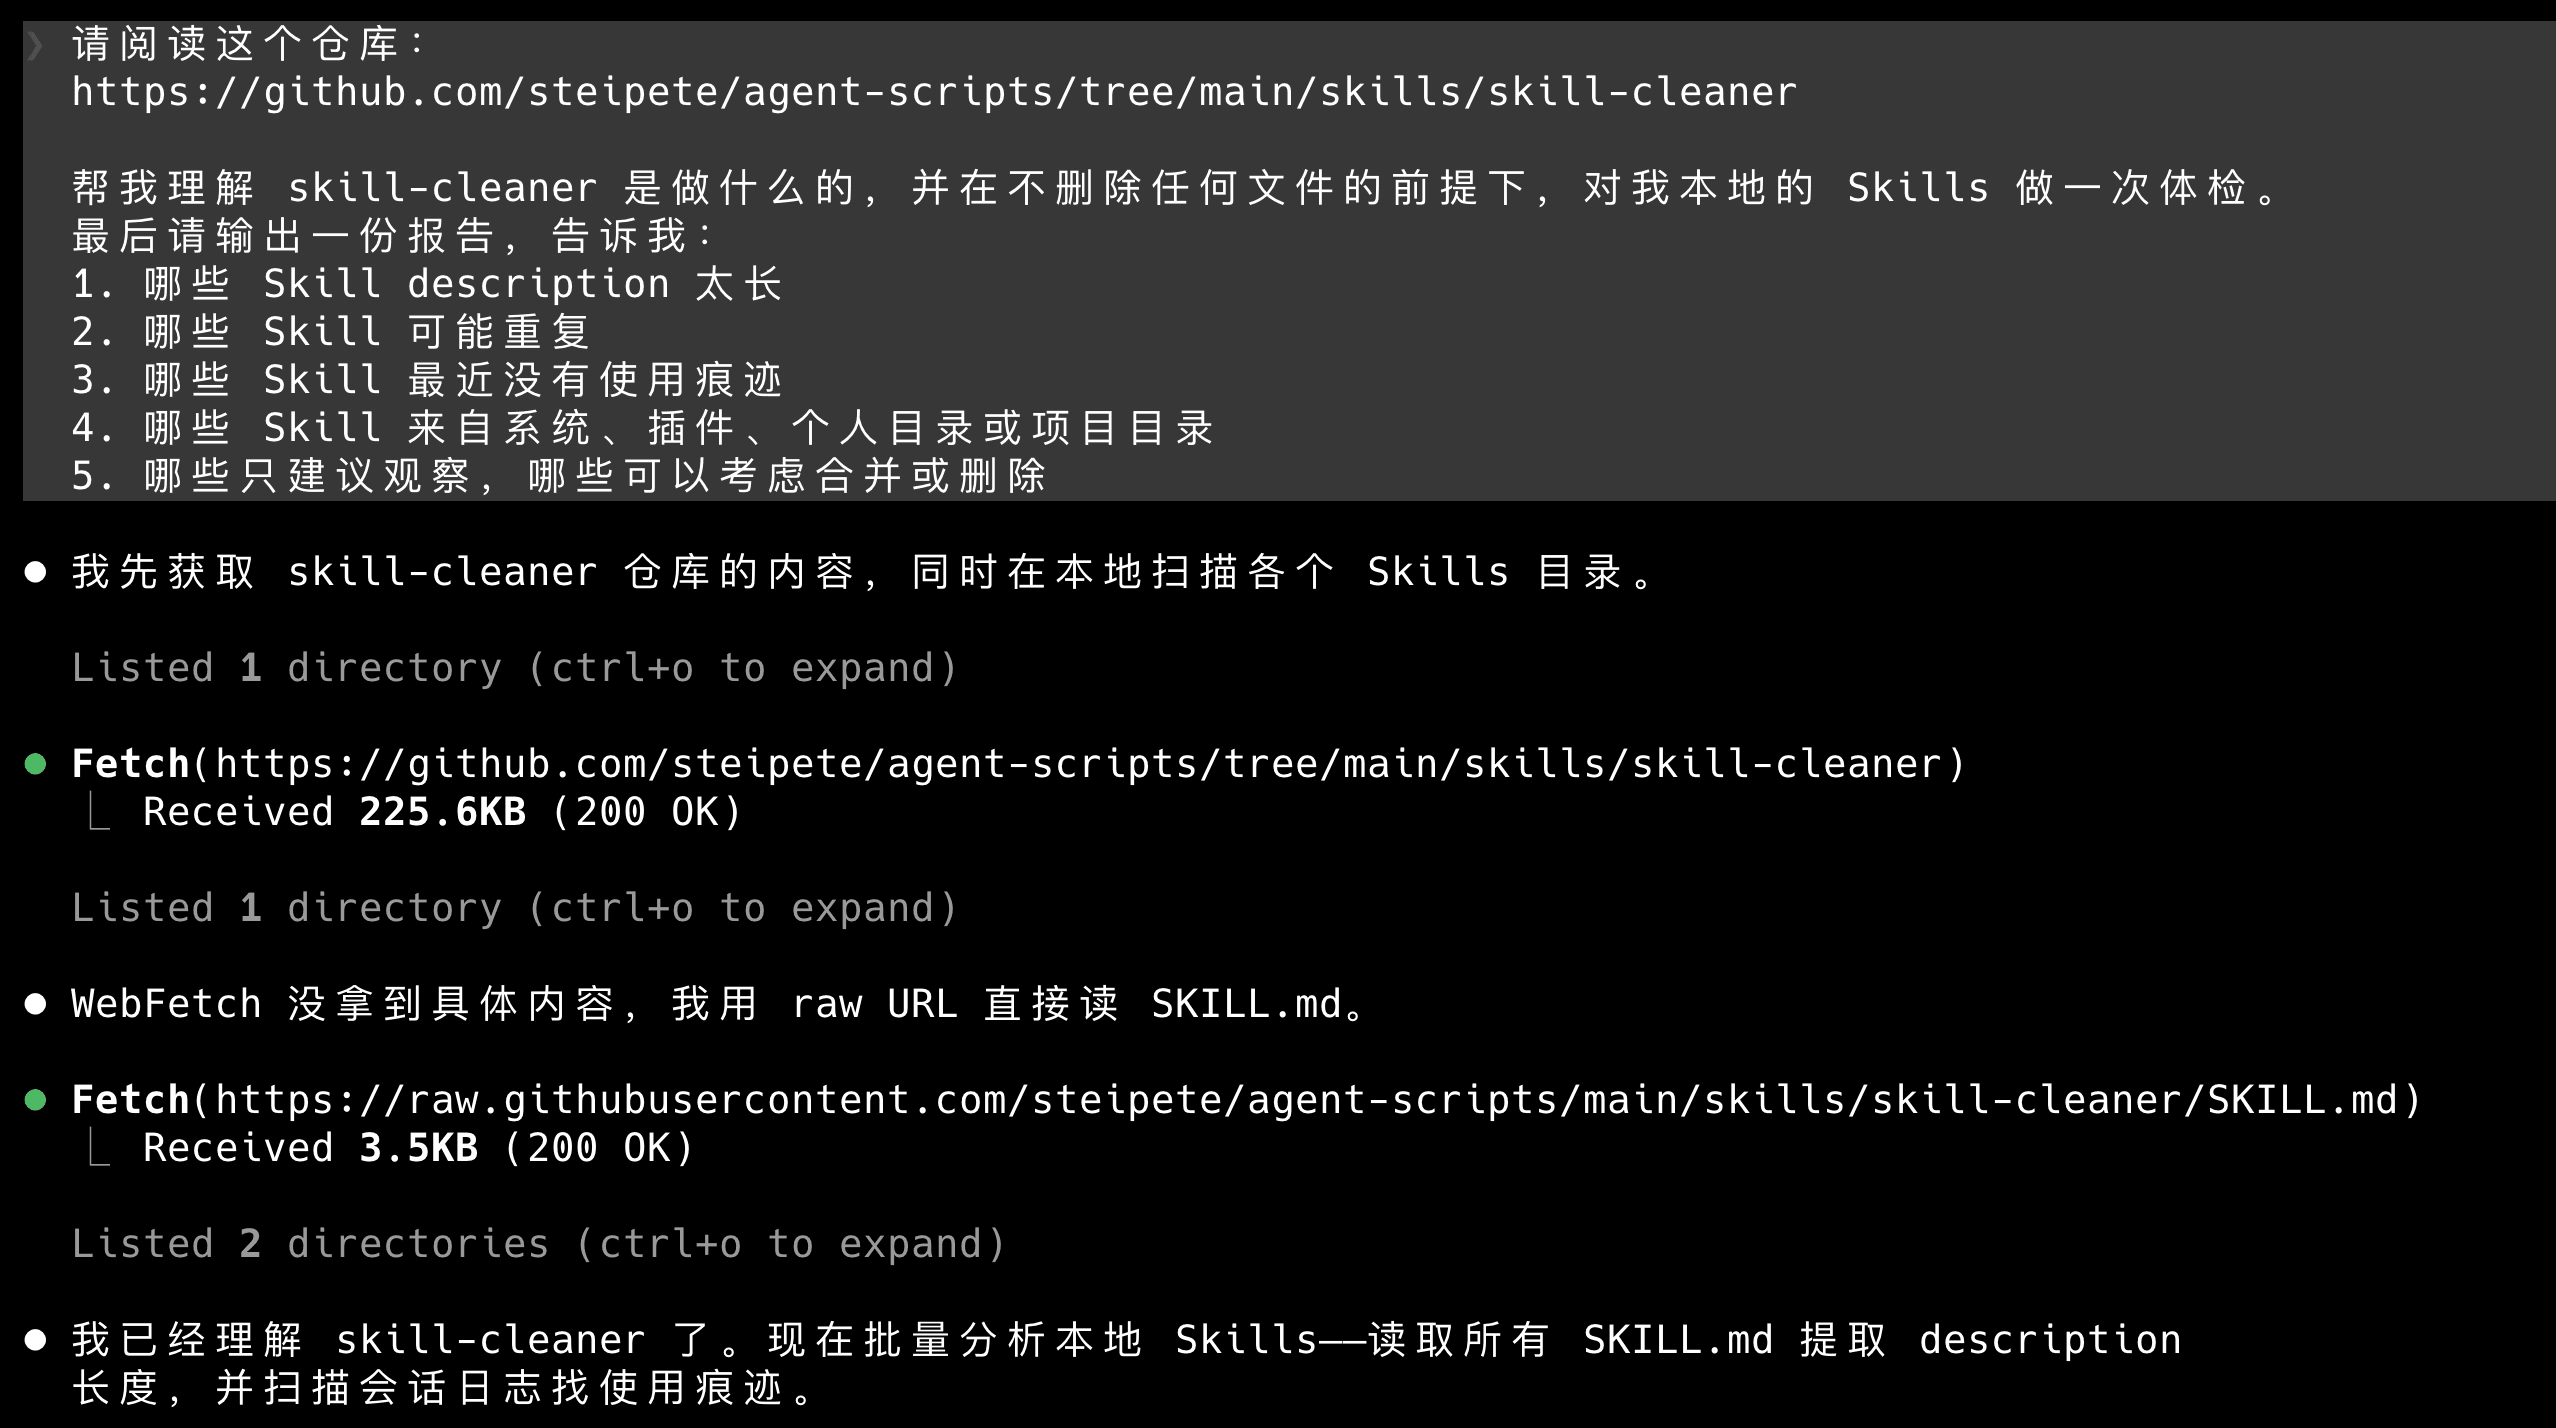
我用 skill-cleaner 给自己的 AI Skills 做了一次体检
这两天看到一个挺有意思的小工具,叫 skill-cleaner。
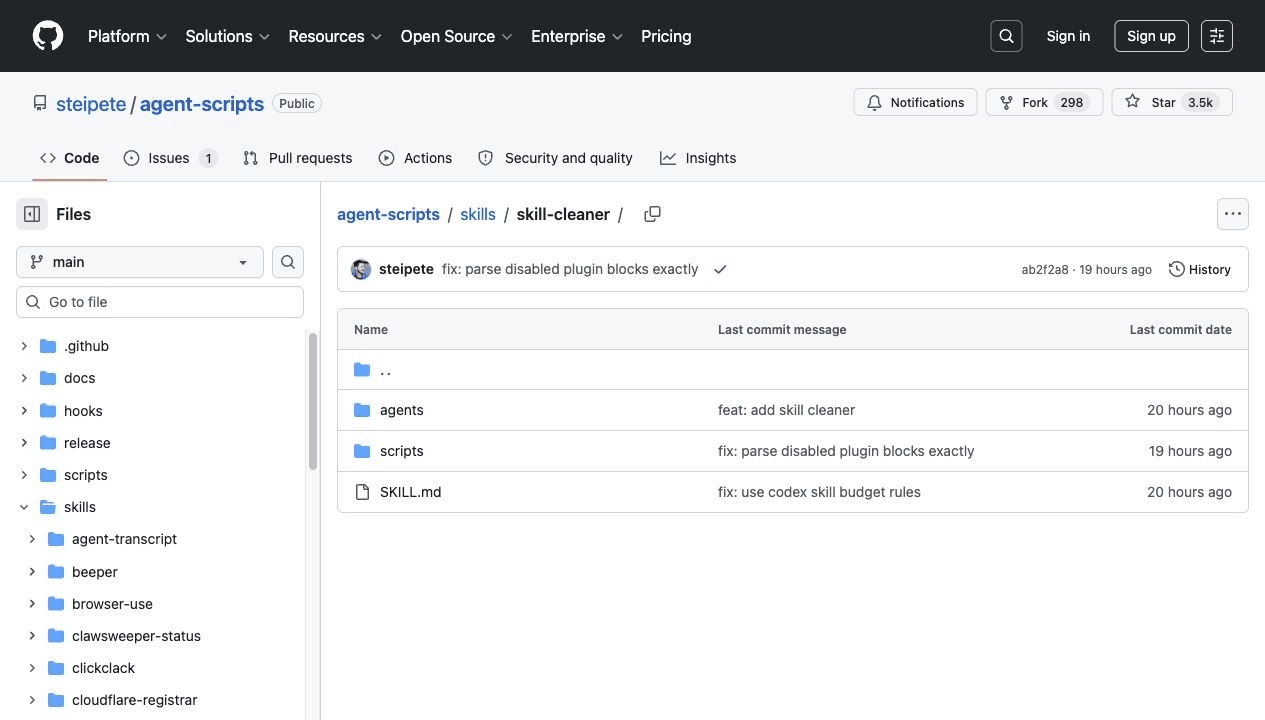
这两天看到一个挺有意思的小工具,叫 skill-cleaner。
它不是帮你写 Skill 的,而是反过来帮你检查现有的 Skills:哪些描述太长,哪些 Skill 重复了,哪些很久没用过,哪些会占掉太多 prompt budget。
每个人手里都装了不少 Claude Code、Codex、OpenClaw 相关的 Skills 吧,这个工具就挺值得看一下。
Skill 多了以后,也会变成负担
Skills 这个机制很好用。
它可以把一套固定工作流写成 Markdown 文件,让 Agent 在遇到相关任务时自动加载,比如代码审查、写文章、操作飞书、处理图片、发布内容等等。
但用久了之后,一个新问题会出现:Skill 会越来越多。
一开始可能只有几个全局 Skill,后来装了插件,又从 GitHub 上下载了一些别人分享的 Skill,再加上项目里自己写的 .codex/skills 或 .claude/skills,最后很容易变成几十个甚至上百个。
这时候问题不是有没有 Skill,而是 Agent 能不能准确找到该用的那个 Skill。
Skill 的名字、描述、位置都会影响模型判断。如果两个 Skill 功能很像,描述又写得差不多,Agent 就可能选错。描述写太长,也会占用 prompt budget。长期不用的 Skill 留在那里,也会让整个工具系统越来越臃肿。
这也是 skill-cleaner 这个工具的价值点。
它主要检查什么
从 GitHub 仓库里的说明看,skill-cleaner 主要做几类检查。
它会先统计 Skill Budget,也就是这些 Skill 描述在模型上下文里占了多少空间。
它按 Codex 的规则估算 token 成本,默认参考 GPT-5.5 的 context size,并按 2% skills budget 来看当前 Skills 列表是否太重。
它还会找 description candidates,也就是描述过长、可以压缩的 Skill。